Transponierte Faltung erklärt für das Hochskalieren von Bildern

Einführung
Faltung neuraler Netzwerke benötigen keine Einführung, wenn es um die Bildverarbeitung mit Deep Neural Networks (DNNs) geht. CNNs bieten eine realistischere Möglichkeit, Merkmale aus einem Bild zu extrahieren und zu lernen, während sie helfen, die Bilddimension zu reduzieren. Aber was ist, wenn wir das Gegenteil wollen?
Angenommen, Sie möchten eine bild-zu-bild Zuordnung durchführen, wie zum Beispiel Bild- oder Instanzsegmentierung oder Super-Auflösung. Für den Fall der semantischen Segmentierung beginnen Sie mit einem Eingabebild, in dem jeder Pixel ein entsprechendes Klassenlabel haben sollte. Nehmen wir nun an, dass Sie versuchen, dieses Problem mit einem CNN gefolgt von einer vollständig verbundenen Schicht zu lösen (wie es in den meisten Modellen zur Bildklassifizierung verwendet wird). Sie werden auf mehrere Probleme stoßen:
- Eine sehr hohe Anzahl von Parametern.
- Verlorene räumliche Merkmale des Bildes.
Angenommen, das Eingangsbild hat die Größe 128×128×3 (128 Pixel Höhe und Breite und 3 Kanäle — RGB). Dann leiten Sie es durch einige Schichten eines CNN und die Ausgangsform ist 44×64. Das bedeutet, dass wir jetzt 1024 Neuronen in unserer ersten versteckten Schicht haben. Versuchen Sie nun, es um den Faktor 32 hochzuskalieren. Selbst wenn Sie die Ausgabeschicht direkt nach dieser Schicht platzieren, wird die Größe der Ausgabeschicht 32.768 betragen.
Um dieses Problem zu lösen, verwenden wir etwas, das man transponierte Faltung nennt, einen Prozess, der als das Gegenteil einer normalen Faltung betrachtet werden kann. Dies wird erreicht, indem das Verbindungsmuster beibehalten wird.
Voraussetzungen
- Convolutional Neural Networks (CNNs): Vertrautheit mit CNNs, ihren Schichten (Faltung, Pooling) und ihrer Rolle in der Bildverarbeitung ist unerlässlich.
- Standard-Convolutionsoperationen: Wissen darüber, wie Standard-Convolutionsoperationen funktionieren, einschließlich Kernel, Schritte, Polsterung und wie sie Merkmale aus Eingabebildern extrahieren.
- Matrixmultiplikation Grundlagen: Das Verständnis desssen, wie Matrizen während Faltungsvorgängen interagieren, wird helfen, die Mechanik der transponierten Faltung zu verstehen.
- Basis-Lineare Algebra: Konzepte wie Skalarprodukte und Transformationen sind grundlegend für das Verständnis, wie die Eingabe in der transponierten Faltung verarbeitet wird.
Angenommen, wir wenden die Faltung auf ein Bild der Größe 5×5×1 an, mit einem Kernel von 3×3, einem Stride von 2×2 und VALID-Padding.
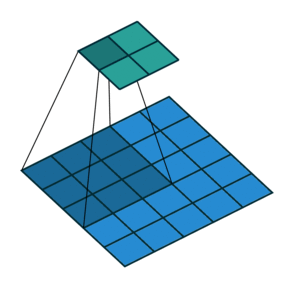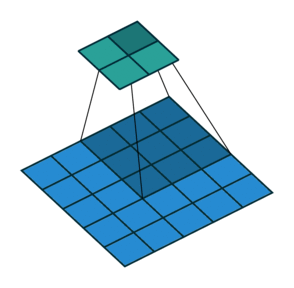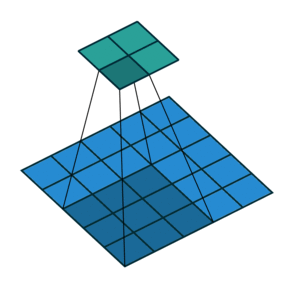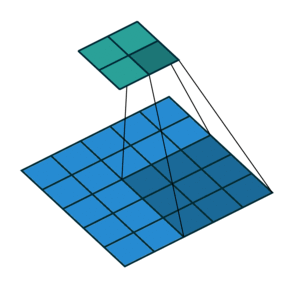
Faltung Operation
Wie Sie im obigen Bild sehen können, wird die Ausgabe ein 2×2-Bild sein. Sie können die Ausgabgröße einer Faltungoperation auch mit der folgenden Formel berechnen:
Die Ausgabegröße der Faltung=1 + (Eingangsgröße - Filtergröße + 2 * Padding)/Schritt
Angenommen, Sie möchten dies auf dieselbe Dimension wie das Eingabebild hochskaliert. Sie verwenden die gleichen Parameter wie für die Faltung und berechnen zunächst, welche Größe das Bild vor der Herunterskalierung hatte. Sie können dies tun, indem Sie die obige Formel von der Größe des Ausgabebildes zur Größe des Eingabebildes (in Höhe oder Breite) ändern. Gültige Polsterung bedeutet, dass es 0 Polsterung um das Bild herum gibt. Gleiche Polsterung bedeutet, dass wir eine Polsterung von Filtergröße/2 ( Abrundungswert) auf allen Seiten hinzufügen.
AUSGABEDIMENSIONEN: Größe des transponierten Faltungsausgangs=(Eingangsgröße - 1) * Schritte + Filtergröße - 2 * Auffüllung + Ausgabepolsterung
Jetzt musst du die Werte in eine Matrix dieser Größe einfüllen. Nun kommt der schwierige Teil: Wie wirst du die gleichen Werte wie die Eingabe erhalten? Die Antwort ist: Das kannst du nicht. Was wirst du also tun, um diese transponierte convolute Matrix jetzt auszufüllen? Befolge die folgenden Schritte:
- Sie werden einen Filter der Größe (Filtergröße * Filtergröße) verwenden und alle Werte des Kerns mit dem ersten Wert des Bildes multiplizieren.
- Platziere dann diesen Filter in der oberen linken Ecke der transponierten Convolution-Matrix.
- Nehmen Sie die Multiplikation des zweiten Pixels und des Filters und legen Sie das Ergebnis in die transponierte Conv-Matrix mit dem angegebenen Stride.
- Wenn es überlappende Werte gibt, füge diese Werte hinzu.
- Wiederholen Sie diesen Prozess, bis die Matrix gefüllt ist und dies das Ergebnis ist.
Wie können wir die Ergebnisse visualisieren, um ein besseres Verständnis zu erhalten? Lassen Sie uns einen naiven Ansatz wählen, um das Ergebnis zu visualisieren. Angenommen, Sie haben das folgende 4×4-Bild als Eingabe.

Ausgabe der Faltung
Angenommen, wir haben dieses 4×4 Bild nach einigen Faltungsschichten erhalten. Jetzt werden wir eine transponierte Faltung anwenden. Für ein besseres Verständnis der transponierten Faltung nehmen wir an, dass alle Werte im Filter einen transparenten Wert haben, was bedeutet, dass sich die Farbe beim Multiplizieren nicht ändern wird. Dies wird uns helfen, die Operation im Vergleich zu Farben zu verstehen; hier nehmen wir an, dass das Hinzufügen einer beliebigen Farbe zu Schwarz immer Schwarz ergibt und das Mischen von RGB-Farben in gleichen Mengen zu Weiß führt. Lassen Sie uns nun mit den folgenden Parametern auf dem obigen Bild versuchen:
Eingabe: 4x4 | Filtergröße: 3x3 | Schritte: 4x4 | Polsterung: 0 | Ausgabepolsterung: 1 Lassen Sie uns überprüfen, was die Ausgangsgröße nach der transponierten Faltungsoperation sein wird. Ausgangsgröße der transponierten Faltung=(4-1) * 4 + 3 - 2 * 0 + 1=16

Ausgabe mit nicht überlappenden Filtern
Was hier passiert ist, dass jedes einzelne Pixel mit einem 3x3-Filter multipliziert wird und ein 3x3-Block bildet, der dann in die Ausgabematrix eingefügt wird. Da wir einen Schritt von 4 haben, werden die Werte dazwischen null sein, was als schwarzer Streifen im Bild zu sehen ist. Wir haben 1 in die Ausgabepolsterung hinzugefügt, was helfen wird, eine gleichmäßig dimensionierte Ausgabe für den Vergleich mit der nächsten Ausgabe zu erhalten.
Eingabe: 4x4 | Filtergröße: 4x4 | Schritte: 4x4 | Polsterung: 0 | Ausgangs-Padding: 0 Lassen Sie uns überprüfen, wie groß die Ausgabe nach der transponierten Faltungsoperation sein wird. Die Ausgangsgröße der transponierten Faltung=(4-1) * 4 + 4 - 2 * 0 + 0=16

Ausgabe mit überlappenden Filtern
Wie im Ergebnis links zu sehen ist, können Sie deutlich mehr Farbe erkennen. Dies ist das Ergebnis der Addition von überlappenden Zellen. Die ersten 4x4 Zellen werden mit roter Farbe (255,0,0) gefüllt und die nächsten 4x4 Zellen werden mit grüner Farbe (0,255,0) gefüllt, und die resultierende Zelle ist (255,255,0), also gelb. Gleiches gilt auch für die anderen Zellen. Sie können sehen, dass überlappende Zellen unterschiedliche Farben haben. Während die Zellen, die mit Weiß überlappen, immer weiß sein werden (weil alle Werte über 255 auf 255 normalisiert werden, was weiß ist), werden die Zellen, die mit Schwarz überlappen, sich ausdehnen (weil Schwarz 0 ist und das Hinzufügen eines Wertes das Gleiche bleibt).
Um die transponierte Faltungsschicht in dein Keras-Modell hinzuzufügen, kannst du die Schicht tf.keras.layers.Conv2DTranspose verwenden. Dies ist Teil deines sequenziellen Modells.
tf.keras.layers.Conv2DTranspose( filters_depth, filter_size, strides=(1, 1), padding='gültig', output_padding=0)
Die transponierte Faltung wird in vielen modernen CNNs verwendet. Neuronale Netzwerke, die Bild-zu-Bild-Übersetzung oder -Generierung durchführen, verwenden die transponierte Faltung.
Jetzt wissen wir, wie wir Transponierte Faltung verwenden, um ein Bild hochzuskalieren. Wenn Sie ein neuronales Netzwerk trainieren, müssen wir die Werte in den Filtern der Transponierten Faltungsschichten bestimmen, genau wie in CNNs. Dort kommt unser Freund Backpropagation zur Hilfe.