Überwachen der Systemauslastung, Ausfälle und Fehlerbehebung bei Linux-Servern - Teil 9
Obwohl Linux sehr zuverlässig ist, sollten kluge Systemadministratoren einen Weg finden, das Verhalten und die Auslastung des Systems jederzeit im Auge zu behalten. Die Gewährleistung einer Betriebszeit von nahezu 100 % und die Verfügbarkeit von Ressourcen sind in vielen Umgebungen von entscheidender Bedeutung. Die Untersuchung des vergangenen und aktuellen Status des Systems wird es uns ermöglichen, mögliche Probleme vorherzusehen und höchstwahrscheinlich zu vermeiden.

Einführung in das Zertifizierungsprogramm der Linux Foundation
In diesem Artikel stellen wir eine Liste einiger Tools vor, die in den meisten Upstream-Distributionen verfügbar sind, um den Systemstatus zu überprüfen, Ausfälle zu analysieren und laufende Probleme zu beheben. Konkret konzentrieren wir uns bei den unzähligen verfügbaren Daten auf die CPU-, Speicherplatz- und Speicherauslastung, das grundlegende Prozessmanagement und die Protokollanalyse.
Nutzung des Speicherplatzes
Es gibt 2 bekannte Befehle in Linux, die verwendet werden, um die Speicherplatznutzung zu überprüfen: df und du.
Die erste, df (was für disk free steht), wird in der Regel verwendet, um die Gesamtnutzung des Speicherplatzes nach Dateisystem anzugeben.
Beispiel 1: Melden der Speicherplatznutzung in Byte und lesbarem Format
Ohne Optionen meldet df die Speicherplatznutzung in Bytes. Mit dem Flag -h werden die gleichen Informationen stattdessen in MB oder GB angezeigt. Beachten Sie, dass dieser Bericht auch die Gesamtgröße jedes Dateisystems (in 1-K-Blöcken), den freien und verfügbaren Speicherplatz sowie den Bereitstellungspunkt jedes Speichergeräts enthält.
# df
df -h

Das ist sicherlich nett – aber es gibt noch eine weitere Einschränkung, die ein Dateisystem unbrauchbar machen kann, und das ist, dass die Inodes ausgehen. Alle Dateien in einem Dateisystem werden einem Inode zugeordnet, der seine Metadaten enthält.
Beispiel 2: Überprüfen der Inode-Nutzung durch Dateisystem in einem menschenlesbaren Format mit
# df -hTi
Sie können die Anzahl der verwendeten und verfügbaren Inodes sehen:

Laut obigem Bild gibt es 146 verwendete Inodes (1%) in /home, was bedeutet, dass Sie in diesem Dateisystem immer noch 226K Dateien erstellen können.
Beispiel 3: Suchen und/oder Löschen von leeren Dateien und Verzeichnissen
Beachten Sie, dass Ihnen der Speicherplatz ausgehen kann, lange bevor Ihnen die Inodes ausgehen, und umgekehrt. Aus diesem Grund müssen Sie nicht nur die Speicherplatzauslastung überwachen, sondern auch die Anzahl der vom Dateisystem verwendeten Inodes.
Verwenden Sie die folgenden Befehle, um leere Dateien oder Verzeichnisse (die 0B belegen) zu finden, die Inodes ohne Grund verwenden:
# find  /home -type f -empty
find  /home -type d -empty
Sie können auch das Flag -delete am Ende jedes Befehls hinzufügen, wenn Sie auch diese leeren Dateien und Verzeichnisse löschen möchten:
# find  /home -type f -empty --delete
find  /home -type f -empty

Durch das vorherige Verfahren wurden 4 Dateien gelöscht. Überprüfen wir noch einmal die Anzahl der verwendeten/verfügbaren Knoten in /home:
# df -hTi | grep home

Wie Sie sehen können, gibt es jetzt 142 gebrauchte Inodes (4 weniger als zuvor).
Beispiel 4: Untersuchen der Festplattennutzung nach Verzeichnis
Wenn die Auslastung eines bestimmten Dateisystems über einem vordefinierten Prozentsatz liegt, können Sie mit du (Abkürzung für Disk Usage) herausfinden, welche Dateien den meisten Speicherplatz belegen.
Das Beispiel wird für /var gegeben, das, wie Sie in der ersten Abbildung oben sehen können, mit 67 % verwendet wird.
# du -sch /var/*

Hinweis: Dass Sie zu einem der oben genannten Unterverzeichnisse wechseln können, um genau herauszufinden, was sich darin befindet und wie viel jedes Element einnimmt. Sie können diese Informationen dann verwenden, um entweder einige Dateien zu löschen, wenn sie nicht benötigt werden, oder die Größe des logischen Datenträgers bei Bedarf zu erweitern.
Lesen Sie auch
- 12 nützliche "df"-Befehle zum Überprüfen des Speicherplatzes
- 10 nützliche "du"-Befehle, um die Festplattenauslastung von Dateien und Verzeichnissen zu ermitteln
Speicher- und CPU-Auslastung
Das klassische Tool in Linux, das verwendet wird, um eine Gesamtüberprüfung der CPU-/Speicherauslastung und des Prozessmanagements durchzuführen, ist der Top-Befehl. Darüber hinaus zeigt top eine Echtzeitansicht eines laufenden Systems an. Es gibt andere Tools, die für den gleichen Zweck verwendet werden könnten, wie z. B. htop, aber ich habe mich für top entschieden, weil es in jeder Linux-Distribution sofort installiert ist.
Beispiel 5: Anzeige eines Live-Status Ihres Systems mit top
Um oben zu beginnen, geben Sie einfach den folgenden Befehl in Ihre Befehlszeile ein und drücken Sie die Eingabetaste.
# top
Schauen wir uns eine typische Top-Ausgabe an:

In den Zeilen 1 bis 5 werden folgende Informationen angezeigt:
1. Die aktuelle Uhrzeit (20:41:32 Uhr) und Betriebszeit (7 Stunden und 41 Minuten). Es ist nur ein Benutzer am System angemeldet, und die durchschnittliche Auslastung in den letzten 1, 5 bzw. 15 Minuten. 0,00, 0,01 und 0,05 geben an, dass das System in diesen Zeitintervallen 0 % der Zeit im Leerlauf war (0,00: keine Prozesse warteten auf die CPU), dann um 1 % (0,01: durchschnittlich 0,01 Prozesse warteten auf die CPU) und 5 % (0,05) überlastet war. Wenn kleiner als 0 und je kleiner die Zahl ist (z. B. 0,65), war das System in den letzten 1, 5 oder 15 Minuten 35 % im Leerlauf, je nachdem, wo 0,65 angezeigt wird.
2. Derzeit laufen 121 Prozesse (die vollständige Liste finden Sie unter 6). Nur 1 von ihnen läuft (in diesem Fall oben, wie Sie in der %CPU-Spalte sehen können) und die restlichen 120 warten im Hintergrund, sind aber "schlafend" und bleiben in diesem Zustand, bis wir sie aufrufen. Wie? Sie können dies überprüfen, indem Sie eine MySQL-Eingabeaufforderung öffnen und einige Abfragen ausführen. Sie werden feststellen, wie die Anzahl der laufenden Prozesse zunimmt.
Alternativ können Sie einen Webbrowser öffnen und zu einer beliebigen Seite navigieren, die von Apache bereitgestellt wird, und Sie erhalten das gleiche Ergebnis. Bei diesen Beispielen wird natürlich davon ausgegangen, dass beide Dienste auf Ihrem Server installiert sind.
3. US (Zeit zum Ausführen von Benutzerprozessen mit unveränderter Priorität), Sy (Zeit zum Ausführen von Kernel-Prozessen), NI (Zeit zum Ausführen von Benutzerprozessen mit geänderter Priorität), WA (Zeit zum Warten auf I/O-Abschluss), HI (Zeit für die Wartung von Hardware-Interrupts), SI (Zeit für die Wartung von Software-Interrupts), ST (Zeit, die vom Hypervisor von der aktuellen VM gestohlen wird – nur in virtualisierten Umgebungen).
4. Auslastung des physischen Speichers.
5. Nutzung des Swap-Speicherplatzes.
Beispiel 6: Überprüfen der Auslastung des physischen Speichers
Um die RAM-, Speicher- und Swap-Nutzung zu überprüfen, können Sie auch den Befehl free verwenden.
# free

Natürlich können Sie auch die Schalter -m (MB) oder -g (GB) verwenden, um die gleichen Informationen in menschenlesbarer Form anzuzeigen:
# free -m

In jedem Fall müssen Sie sich der Tatsache bewusst sein, dass der Kernel so viel Speicher wie möglich reserviert und ihn Prozessen zur Verfügung stellt, wenn diese ihn anfordern. Insbesondere zeigt die Zeile "-/+ buffers/cache" die tatsächlichen Werte nach Berücksichtigung dieses I/O-Caches an.
Mit anderen Worten, die Menge an Arbeitsspeicher, die von Prozessen verwendet wird, und die Menge, die anderen Prozessen zur Verfügung steht (in diesem Fall 232 MB verwendet bzw. 270 MB verfügbar). Wenn Prozesse diesen Speicher benötigen, verringert der Kernel automatisch die Größe des I/O-Caches.
Lesen Sie auch: 10 nützliche "kostenlose" Befehle zur Überprüfung der Linux-Speicherauslastung
Prozesse unter die Lupe nehmen
Zu jeder Zeit laufen viele Prozesse auf unserem Linux-System. Es gibt zwei Tools, die wir verwenden werden, um Prozesse genau zu überwachen: ps und pstree.
Beispiel 7: Anzeige der gesamten Prozessliste in Ihrem System mit ps (vollständiges Standardformat)
Mit den Optionen -e und -f, die zu einer Option (-ef) zusammengefasst sind, können Sie alle Prozesse auflisten, die derzeit auf Ihrem System ausgeführt werden. Sie können diese Ausgabe an andere Tools weiterleiten, z. B. grep (wie in Teil 1 der LFCS-Reihe erläutert), um die Ausgabe auf die gewünschten Prozesse einzugrenzen:
# ps -ef | grep -i squid | grep -v grep

Die obige Prozessliste zeigt die folgenden Informationen:
Besitzer des Prozesses, PID, übergeordnete PID (der übergeordnete Prozess), Prozessorauslastung, Zeitpunkt, zu dem der Befehl gestartet wurde, tty (das ? gibt an, dass es sich um einen Daemon handelt), die kumulierte CPU-Zeit und der Befehl, der dem Prozess zugeordnet ist.
Beispiel 8: Anpassen und Sortieren der Ausgabe von ps
Vielleicht benötigen Sie jedoch nicht all diese Informationen und möchten den Besitzer des Prozesses, den Befehl, der ihn gestartet hat, seine PID und PPID sowie den Prozentsatz des derzeit verwendeten Speichers anzeigen – in dieser Reihenfolge und sortieren Sie nach Speicherverbrauch in absteigender Reihenfolge (beachten Sie, dass ps standardmäßig nach PID sortiert ist).
# ps -eo user,comm,pid,ppid,%mem --sort -%mem
Dabei zeigt das Minuszeichen vor %mem die Sortierung in absteigender Reihenfolge an.

Wenn ein Prozess aus irgendeinem Grund anfängt, zu viele Systemressourcen zu beanspruchen und wahrscheinlich die Gesamtfunktionalität des Systems gefährdet, sollten Sie seine Ausführung stoppen oder pausieren, indem Sie eines der folgenden Signale mit dem Kill-Programm an ihn übergeben. Ein weiterer Grund, warum Sie dies in Betracht ziehen sollten, ist, wenn Sie einen Prozess im Vordergrund gestartet haben, ihn aber anhalten und im Hintergrund fortsetzen möchten.
| Signalname | Signalnummer | Beschreibung |
| SIGTERM | 15 | Beenden Sie den Prozess elegant. |
| SIGINT | 2 | Dies ist das Signal, das gesendet wird, wenn wir Strg + C drücken. Es zielt darauf ab, den Prozess zu unterbrechen, aber der Prozess kann dies ignorieren. |
| SIGKILL | 9 | Dieses Signal unterbricht den Prozess ebenfalls, aber es tut dies bedingungslos (mit Vorsicht verwenden!), da ein Prozess es nicht ignorieren kann. |
| SIGHUP | 1 | Die Abkürzung für "Hang UP", dieses Signal weist Daemons an, ihre Konfigurationsdatei erneut zu lesen, ohne den Prozess tatsächlich zu stoppen. |
| SIGTSTP | 20 | Ausführung anhalten und warten, um fortzufahren. Dies ist das Signal, das gesendet wird, wenn wir die Tastenkombination Strg + Z eingeben. |
| SIGSTOP | 19 | Der Prozess wird pausiert und erhält keine Aufmerksamkeit mehr von den CPU-Zyklen, bis er neu gestartet wird. |
| SIGCONT | 18 | Dieses Signal weist den Prozess an, die Ausführung fortzusetzen, nachdem er entweder SIGTSTP oder SIGSTOP empfangen hat. Dies ist das Signal, das von der Shell gesendet wird, wenn wir die Befehle fg oder bg verwenden. |
Beispiel 9: Anhalten der Ausführung eines laufenden Prozesses und Fortsetzen im Hintergrund
Wenn die normale Ausführung eines bestimmten Prozesses impliziert, dass während der Ausführung keine Ausgabe an den Bildschirm gesendet wird, können Sie ihn entweder im Hintergrund starten (indem Sie am Ende des Befehls ein kaufmännisches Und-Zeichen anhängen).
process_name &
oder,
Sobald es im Vordergrund läuft, pausieren Sie es und senden Sie es in den Hintergrund mit
Ctrl + Z
# kill -18 PID

Beispiel 10: Gewaltsames Töten eines "wild gewordenen" Prozesses
Bitte beachten Sie, dass jede Distribution Werkzeuge zum ordnungsgemäßen Stoppen/Starten/Neustarten/Neuladen gängiger Dienste bereitstellt, wie z.B. service in SysV-basierten Systemen oder systemctl in systemd-basierten Systemen.
Wenn ein Prozess nicht auf diese Dienstprogramme reagiert, können Sie ihn gewaltsam beenden, indem Sie ihm das SIGKILL-Signal senden.
# ps -ef | grep apache
kill -9 3821

Also.. Was ist passiert/passiert?
Wenn es irgendeine Art von Ausfall im System gegeben hat (sei es ein Stromausfall, ein Hardwarefehler, eine geplante oder ungeplante Unterbrechung eines Prozesses oder eine Anomalie überhaupt), sind die Protokolle in /var/log Ihre besten Freunde, um festzustellen, was passiert ist oder was die Probleme verursachen könnte, mit denen Sie konfrontiert sind.
# cd /var/log
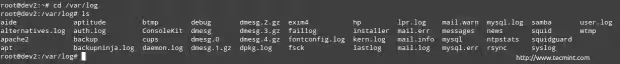
Einige der Elemente in /var/log sind reguläre Textdateien, andere sind Verzeichnisse und wieder andere sind komprimierte Dateien von rotierten (historischen) Protokollen. Sie sollten diejenigen überprüfen, die das Wort Fehler in ihrem Namen haben, aber es kann auch nützlich sein, den Rest zu überprüfen.
Beispiel 11: Untersuchen von Protokollen auf Fehler in Prozessen
Stellen Sie sich dieses Szenario vor. Ihre LAN-Clients sind nicht in der Lage, auf Netzwerkdruckern zu drucken. Der erste Schritt zur Fehlerbehebung in dieser Situation besteht darin, in das Verzeichnis /var/log/cups zu gehen und zu sehen, was sich dort befindet.
Sie können den Befehl tail verwenden, um die letzten 10 Zeilen der error_log Datei anzuzeigen, oder tail -f error_log, um eine Echtzeitansicht des Protokolls zu erhalten.
# cd /var/log/cups
ls
tail error_log

Der obige Screenshot enthält einige hilfreiche Informationen, um zu verstehen, was Ihr Problem verursachen könnte. Beachten Sie, dass das Befolgen der Schritte oder das Beheben der Fehlfunktion des Prozesses das Gesamtproblem möglicherweise nicht löst, aber wenn Sie sich von Anfang an daran gewöhnen, jedes Mal, wenn ein Problem auftritt (sei es ein lokales oder ein Netzwerkproblem), die Protokolle zu überprüfen, sind Sie definitiv auf dem richtigen Weg.
Beispiel 12: Untersuchen der Protokolle auf Hardwarefehler
Obwohl die Fehlerbehebung bei Hardwarefehlern schwierig sein kann, sollten Sie die dmesg- und Meldungsprotokolle und grep auf verwandte Wörter zu einem Hardwareteil überprüfen, das als fehlerhaft gilt.
Das folgende Bild stammt aus /var/log/messages, nachdem Sie mit dem folgenden Befehl nach dem Wort error gesucht haben:
# less /var/log/messages | grep -i error
Wir können sehen, dass wir ein Problem mit zwei Speichergeräten haben: /dev/sdb und /dev/sdc, die wiederum ein Problem mit dem RAID-Array verursachen.

Schlussfolgerung
In diesem Artikel haben wir einige der Tools untersucht, die Ihnen helfen können, immer den Gesamtstatus Ihres Systems im Auge zu behalten. Darüber hinaus müssen Sie sicherstellen, dass Ihr Betriebssystem und die installierten Pakete auf die neuesten stabilen Versionen aktualisiert werden. Und vergessen Sie niemals, die Protokolle zu überprüfen! Dann sind Sie auf dem richtigen Weg, um die endgültige Lösung für alle Probleme zu finden.
Fühlen Sie sich frei, Ihre Kommentare, Vorschläge oder Fragen - falls Sie welche haben - über das untenstehende Formular zu hinterlassen.