Reguläre Python-Ausdrücke mit Beispielen
Ein regulärer Ausdruck (oft abgekürzt als "regex") ist eine Technik und ein textuelles Muster, das definiert, wie man eine bestimmte Zeichenkette suchen oder ändern möchte. Reguläre Ausdrücke werden häufig in Bash-Shell-Skripten und in Python-Code sowie in verschiedenen anderen Programmiersprachen verwendet.
In diesem Tutorial lernen Sie:
- So beginnen Sie mit regulären Ausdrücken in Python
- So importieren Sie das Regex-Python-Modul
- So ordnen Sie Zeichenfolgen und Zeichen mit der Regex-Notation ab
- So verwenden Sie die gebräuchlichsten Python-Regex-Notationen
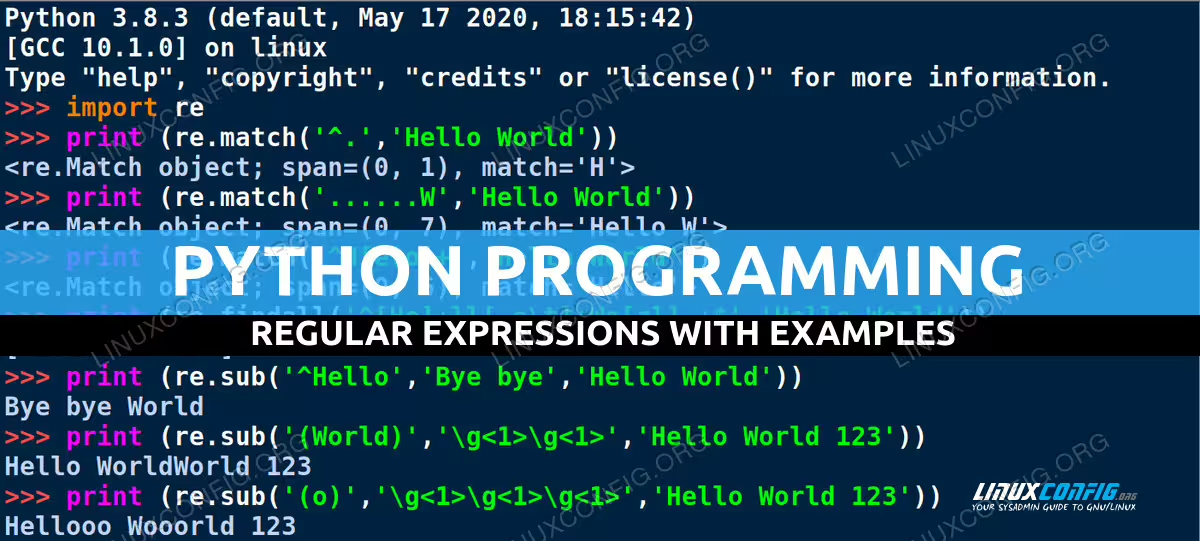
Reguläre Python-Ausdrücke mit Beispielen
Verwendete Softwareanforderungen und Konventionen
| Kategorie | Anforderungen, Konventionen oder verwendete Softwareversion |
|---|---|
| System | Jedes GNU/Linux-Betriebssystem |
| Software | Python 2, Python 3 |
| Andere | Privilegierter Zugriff auf Ihr Linux-System als root oder über den Befehl sudo. |
Beispiele für reguläre Python-Ausdrücke
In Python möchte man das re-Modul importieren, um die Verwendung von regulären Ausdrücken zu ermöglichen.
Beispiel 1 Beginnen wir mit einem einfachen Beispiel:
python3
Python 3.8.2 (default, Apr 27 2020, 15:53:34)
[GCC 9.3.0] on linux
Type "help", "copyright", "credits" or "license" for more information.
>>> print ('Hello World')
Hello World
>>> import re
>>> print (re.match('^.','Hello World'))
Hier haben wir zuerst Hello World Zeile 5 gedruckt, um eine einfache Druckeinrichtung zu demonstrieren. Wir haben dann das Regex-Modul re Zeile 7 importiert, das es uns ermöglicht, die Matching-Funktion für den regulären Ausdruck .match Zeile 8 dieser Bibliothek zu verwenden.
Die Syntax der .match-Funktion lautet (pattern,string), wobei pattern als regulärer Ausdruck ^. definiert wurde und wir denselben Hello World-String als Eingabestring verwendet haben.
Wie Sie sehen können, wurde eine Übereinstimmung im Buchstaben H gefunden. Der Grund, warum diese Übereinstimmung gefunden wurde, ist das Muster des regulären Ausdrucks, nämlich; ^ steht für den Anfang des Strings und . steht für Übereinstimmung mit einem beliebigen Zeichen (außer Zeilenumbruch).
So wurde H gefunden, da dieser Buchstabe direkt nach "dem Anfang der Zeichenfolge" steht und als "beliebiges Zeichen, in diesem Fall H" beschrieben wird.
Diese speziellen Konnotationen sind identisch mit regulären Ausdrücken in Bash-Skripten und anderen Regex-fähigen Anwendungen, die alle einen mehr oder weniger einheitlichen Regex-Standard verwenden, obwohl es Unterschiede zwischen Sprachen und sogar spezifischen Implementierungen gibt, wenn man sich etwas weiter mit regulären Ausdrücken beschäftigt.
Beispiel 2
>>> print (re.match('......W','Hello World'))
<re.Match object; span=(0, 7), match='Hello W'>
Hier verwenden wir . um ein beliebiges Zeichen (außer Zeilenumbruch) zu finden, und wir tun dies 6 Mal, bevor wir das Literalzeichen W abgleichen.
Wie Sie sehen können, wurde Hello W (7 Zeichen) abgeglichen. Interessanterweise wird dies als span (0,7) angezeigt, was nicht als 0-7 gelesen werden sollte (was 8 Zeichen entspricht), sondern als "Start bei 0" "+7 Zeichen", wie man auch aus den anderen Beispielen in diesem Artikel ersehen kann.
Beispiel 3 Nehmen wir ein weiteres, etwas komplexeres Beispiel:
>>> print (re.match('^H[elo]+','Hello World'))
<re.Match object; span=(0, 5), match='Hello'>
Die Syntax lautet in diesem Fall:
- ^: wie oben beschrieben, kann auch gelesen werden als 'dies muss der Anfang des Strings sein'
- H: muss genau an dieser Stelle mit
Hübereinstimmen (die direkt nach/am Anfang der Zeichenkette liegt) - [elo]+: entspricht entweder
e,lodero(das 'entweder', definiert durch[' und ']) und+bedeutet 'eines oder mehrere von diesen'
Somit wurde Hello so abgeglichen, wie H tatsächlich am Anfang der Zeichenkette stand, und e und o und l wurden ein- oder mehrmals (in beliebiger Reihenfolge) abgeglichen.
Beispiel 3Bereit für ein superkomplexes Beispiel?
>>> print (re.findall('^[He]+ll[ o\t]+Wo[rl].+$','Hello World'))
['Hello World'];
Hier haben wir eine weitere Funktion des re-Moduls verwendet, nämlich findall, die sofort den gefundenen String liefert und die gleiche (pattern,string) Syntax verwendet.
Warum stimmte Hello World vollständig überein? Lassen Sie es uns Schritt für Schritt aufschlüsseln:
- ^: Anfang des Strings
- [He]+: Stimmt 1 oder mehr Mal mit
hundeüberein, und somit isterübereinstimmend - ll: wörtliche Übereinstimmung von
llan genau dieser Stelle, und somit wirdlltatsächlich so abgeglichen, wie es direkt nachHekam - [ o\t]+: Entspricht entweder
' '(Leerzeichen) oderooder\t(ein Tabulator), und das 1 oder mehrmals, und somito(o Leerzeichen) stimmt überein. Wenn wir einen Tabulator anstelle eines Leerzeichens verwendet hätten, würde dieser Regex immer noch funktionieren! - Wo: Wörtliche Übereinstimmung von
Wo - [rl]: Entspricht entweder
RoderL. Beobachten Sie genau; Hier wird nurRübertroffen! Es gibt kein+hinter dem],so dass nur ein einzelnes Zeichen, entwederroderl, an dieser Position abgeglichen wird. Warum wurderldimmer noch abgeglichen? Die Antwort liegt im nächsten Qualifikationskriterium; - .+: entspricht einem beliebigen Zeichen (gekennzeichnet durch
.) ein- oder mehrmals, sodasslunddbeide übereinstimmen und unsere Zeichenkette vollständig ist - $: Ähnlich wie
^bedeutet dieses Zeichen "Ende des Strings".
Mit anderen Worten, wenn wir dies an den Anfang oder an eine andere Stelle in der Mitte gesetzt hätten, hätte der Regex nicht zusammengepasst.
Als Beispiel:
>>> print (re.findall('^Hello$','Hello World'))
[]

>>> print (re.findall('^Hello$','Hello '))
[]

>>> print (re.findall('^Hello$','Hello'))
['Hello']

>>> print (re.findall('^Hello','Hello World'))
['Hello']
Hier wird für die ersten beiden Drucke keine Ausgabe zurückgegeben, da wir versuchen, einen String, der als "start_of_string"-Hello-"end_of_string" gelesen werden kann, wie durch ^Hello$ gekennzeichnet, mit Hello World abzugleichen, der nicht übereinstimmt.
Im dritten Beispiel stimmt ^Hello$ mit Hello überein, da die Hello-Zeichenfolge keine zusätzlichen Zeichen enthält, die dazu führen würden, dass dieser reguläre Ausdruck nicht übereinstimmen kann. Das letzte Beispiel schließlich zeigt eine teilweise Übereinstimmung, ohne dass das "end_of_string" ($) erforderlich ist.
Siehe? Sie werden bereits zum Experten für reguläre Ausdrücke! Reguläre Ausdrücke können Spaß machen und sind sehr mächtig!
Beispiel 4
Es gibt verschiedene andere Funktionen im re-Python-Modul, wie re.sub, re.split, re.subn, re.search, jede mit ihren anwendbaren Anwendungsfalldomänen. Schauen wir uns als nächstes re.sub an:
>>> print (re.sub('^Hello','Bye bye','Hello World'))
Bye bye World
Die Zeichenfolgenersetzung ist eine der leistungsfähigsten Anwendungen von regulären Ausdrücken in Python und anderen Programmiersprachen. In diesem Beispiel haben wir nach ^Hello gesucht und es durch Bye bye in der Zeichenfolge Hello World ersetzt. Können Sie sich vorstellen, dass dies sehr praktisch wäre, um alle Arten von Variablen und Textstrings und sogar ganze flache Textdateien zu verarbeiten?
Beispiel 5
Schauen wir uns einige komplexere Beispiele an, die eine fortgeschrittenere Regex-Syntax verwenden:
>>> print (re.sub('[0-9]+','_','Hello World 123'))
Hello World _- [0-9]+: Jedes numerische Zeichen zwischen
0und9, ein- oder mehrmals.
Können Sie sehen, wie die 123 durch ein einzelnes _ ersetzt wurde?
Beispiel 6
>>> print (re.sub('(?i)[O-R]+','_','Hello World 123'))
Hell_ W_ld 123- (?i)[O-R]+: Ordnen Sie ein oder mehrere
ObisRoder – dank des optionaleni-Flags–obisrzu - (?i): Voreinstellung eines i-Flags
ohne Berücksichtigung der Groß- und Kleinschreibung für dieses Muster
>>> print (re.sub('[1]{2}','_','Hello World 111'))
Hello World _1- [1]{2}: Kombiniere das Zeichen
1genau zweimal
Beispiel 7
>>> print (re.sub('(World)','\g<1>\g<1>','Hello World 123'))
Hello WorldWorld 123- (World): Passen Sie den Literaltext 'World' an und machen Sie ihn zu einer Gruppe, die dann in der Ersetzung verwendet werden kann
Beispiel 8
Um dies zu verdeutlichen, betrachten Sie die folgenden zwei Beispiele:
>>> print (re.sub('(o)','\g<1>\g<1>\g<1>','Hello World 123'))
Hellooo Wooorld 123
In diesem ersten Beispiel ordnen wir einfach o zu und platzieren es in einer Gruppe, dann wiederholen wir diese Gruppe dreimal im Out.
Beachten Sie, dass, wenn wir uns nicht auf Gruppe 1 beziehen würden (die erste übereinstimmende Gruppe, siehe zweites Beispiel), es einfach keine Ausgabe geben würde und das Ergebnis wäre:
>>> print (re.sub('(o)','','Hello World 123'))
Hell Wrld 123
Betrachten Sie für das zweite Beispiel:
>>> print (re.sub('(o).*(r)','\g<1>\g<2>','hello world 123'))
hellorld 123
Hier haben wir zwei Gruppen, wobei die erste o ist (überall dort, wo eine solche Gruppe übereinstimmt, und es gibt eindeutig mehrere, wie im ersten Beispiel zu sehen ist), und die zweite r ist. Zusätzlich verwenden wir .*, was übersetzt "beliebiges Zeichen, beliebig viele Male" bedeutet – ein häufig verwendeter regulärer Ausdruck.
In diesem Beispiel wird o wor also mit (o) abgeglichen.*(r)' ('o zuerst, dann jedes Zeichen, bis das letzte r erreicht ist. "Der letzte" Begriff ist sehr wichtig und ein leicht zu machender Fehler/Haken, insbesondere für neue Benutzer regulärer Ausdrücke. Betrachten Sie als Nebenbeispiel:
>>> print (re.sub('e.*o','_','hello world 123'))
h_rld 123
Können Sie sehen, wie das letzte o zugeordnet wurde?
Um auf unser Beispiel zurückzukommen:
>>> print (re.sub('(o).*(r)','\g<1>\g<2>','hello world 123'))
hellorld 123
Wir können sehen, dass o wor durch eine Übereinstimmung der Gruppe 1 gefolgt von einer Übereinstimmung der Gruppe 2 ersetzt wurde, was dazu führt: o wor wird durch oder ersetzt und somit ist die Ausgabe hellorld 123.
Schlussfolgerung
Schauen wir uns einige der gebräuchlichsten Notationen für reguläre Ausdrücke an, die in Python verfügbar sind, abgeglichen mit einigen leichtgewichtigen Implementierungen derselben:
| Regex-Notation | Beschreibung |
|---|---|
| Beliebiges Zeichen, außer Zeilenumbruch |
| Ein Zeichen des ausgewählten Bereichs, in diesem Fall a,b,c |
| Ein Zeichen des ausgewählten Bereichs, in diesem Fall A-Z |
| Ein Zeichen des ausgewählten Bereichs, in diesem Fall 0-9, A und F-Z |
| Ein Zeichen außerhalb des ausgewählten Bereichs, in diesem Fall z. B. "1", würde sich qualifizieren |
| Beliebig viele Übereinstimmungen (0 oder mehr) |
| 1 oder mehr Übereinstimmungen |
| 0 oder 1 Treffer |
| Genau 3 Spiele |
| Gruppe erfassen. Wenn diese zum ersten Mal verwendet wird, ist die Gruppennummer 1 usw. |
| Verwendung (Einfügen) der Capture-Match-Gruppe, qualifiziert durch die Nummer (1-x) der Gruppe |
| Spezielle Gruppe 0 fügt die gesamte übereinstimmende Zeichenkette ein |
| Anfang der Zeichenfolge |
| Ende der Zeichenkette |
| Eine Ziffer |
| Eine nicht ziffernlose Ziffer |
| Ein Leerzeichen |
| Ein Nicht-Leerzeichen |
| Ignorieren Sie das Präfix des Fallflags, wie oben gezeigt |
| Eines der beiden Zeichen (eine Alternative zur Verwendung von []), 'a' oder 'd' |
| Escapezeichen für Sonderzeichen |
| Rücktaste |
| Zeilenumbruch |
| Wagenrücklauf-Zeichen |
| Tabstoppzeichen |
Interessant? Sobald Sie anfangen, reguläre Ausdrücke in jeder Sprache zu verwenden, werden Sie bald feststellen, dass Sie sie überall verwenden – in anderen Programmiersprachen, in Ihrem bevorzugten Texteditor mit regex-fähigem Ausdruck, auf der Befehlszeile (siehe 'sed' für Linux-Benutzer) usw.
Sie werden wahrscheinlich auch feststellen, dass Sie sie eher ad-hoc verwenden werden, d.h. nicht nur in der Programmierung. Es hat etwas von Natur aus Mächtiges, in der Lage zu sein, alle Arten von Befehlszeilenausgaben zu steuern, z. B. Verzeichnis- und Dateiauflistungen, Skripterstellung und Flatfile-Textverwaltung.
Genießen Sie Ihren Lernfortschritt und posten Sie bitte unten einige Ihrer aussagekräftigsten Beispiele für reguläre Ausdrücke!